/es/articulos/cloudflare-ya-te-deja-ponerle-tope-de-gasto-workers-y-durable
Cloudflare ya te deja ponerle tope de gasto a Workers y Durable Objects: al llegar al límite, los pausa
Cloudflare por fin le puso freno de mano a la factura. El 13 de noviembre de 2026 anunció Spend Management, en beta para cualquier cliente de pago por uso (PayGo): ahora puedes fijar un límite de gasto en dólares para Workers y Durable Objects y, si se alcanza, Cloudflare pausa el producto en lugar de seguir cobrando. Hasta ahora solo había avisos por correo; la propia empresa lo resume en su anuncio: «informar no es lo mismo que controlar». Para quien tiene un Worker expuesto a internet, un bucle mal escrito o un pico de tráfico inesperado, es la diferencia entre enterarte del susto por correo o enterarte en la factura. Pero el freno tiene letra chiquita, y conviene leerla antes de activarlo en producción.
Qué anunció Cloudflare
Según el blog de Cloudflare, los controles de gasto eran desde hace tiempo una de las funciones más pedidas por quienes construyen en su plataforma, que ya suma más de 10 millones de desarrolladores. Lo que había antes eran notificaciones de uso por producto y alertas de presupuesto para toda la cuenta; la documentación es explícita en que esas alertas son solo informativas: «no pausan ni limitan el uso».
Spend Management agrega dos cosas por producto:
- Límite de gasto: al llegar al monto, Cloudflare bloquea las operaciones del producto.
- Alerta por correo: avisa al llegar al umbral, pero el producto sigue corriendo.
En la API de facturación, cada límite o alerta se llama spend policy. Se configura desde el dashboard (en Billing, sección de Spend Management), desde la CLI cf o por la API REST. Cloudflare dice que más productos se sumarán pronto.
Cómo se configura
En el dashboard, eliges Workers o Durable Objects, escribes un monto mensual en dólares (mayor que cero, con hasta dos decimales) y guardas. La documentación aclara varios detalles que no son obvios:
- El ciclo no es el mes calendario. El límite se reinicia cuando empieza tu periodo de facturación de la suscripción. Si te suscribiste un día 10, tu ciclo va del 10 al 10.
- Cuenta lo que ya gastaste. El límite aplica sobre el uso registrado en el periodo actual: si guardas un límite de 50 dólares cuando ya llevas 60, el producto se puede pausar en cuanto Cloudflare evalúe la política.
- Los correos llegan al 80% y al 100%. Si el gasto brinca los dos umbrales entre una evaluación y otra, puede que solo recibas el del 100%.
- El dashboard no pone correo por defecto. Los límites creados ahí no tienen destinatario; para que te avisen hay que actualizar la política con un
notification_email. - Queda bitácora. Un registro de auditoría muestra quién cambió un límite y cuándo, y también cuándo se alcanzó un umbral.
Por API se ve así (ejemplo del propio anuncio, con un tope de 100 dólares expresado en centavos):
curl --fail-with-body --request POST \
  "https://api.cloudflare.com/client/v4/accounts/${CLOUDFLARE_ACCOUNT_ID}/billing/spend-policies" \
  --header "Authorization: Bearer ${CLOUDFLARE_API_TOKEN}" \
  --header "Content-Type: application/json" \
  --data '{"name": "Workers spending cap", "product_id": "workers", "enabled": true,
          "threshold_cents": 10000, "action": "usage_block",
          "notification_email": "me@example.com"}'
La CLI tiene el ciclo completo: cf billing spend-policies list, create, get, update, delete, y además audit list y activity list para revisar historial. No lo probé; todo esto sale del anuncio y de la documentación oficial de Cloudflare.
Qué cuenta y qué no
El límite usa los cargos por uso estimados, después de descontar lo incluido en el plan, y en dólares. De acuerdo con la documentación:
| Producto | Cuenta para el límite | No cuenta |
|---|---|---|
| Workers | Peticiones y tiempo de CPU | La cuota de Workers Paid y cargos de otros productos |
| Durable Objects | Peticiones, duración, filas de SQLite leídas y escritas, operaciones de almacenamiento clave-valor | Datos almacenados y la cuota compartida de Workers Paid |
Un límite de Workers no incluye Durable Objects, Workers AI, Workers KV ni R2. Y no se puede apuntar a un Worker o a un namespace en particular: cada límite cubre todo el producto en toda la cuenta.
Qué se apaga cuando llegas al tope
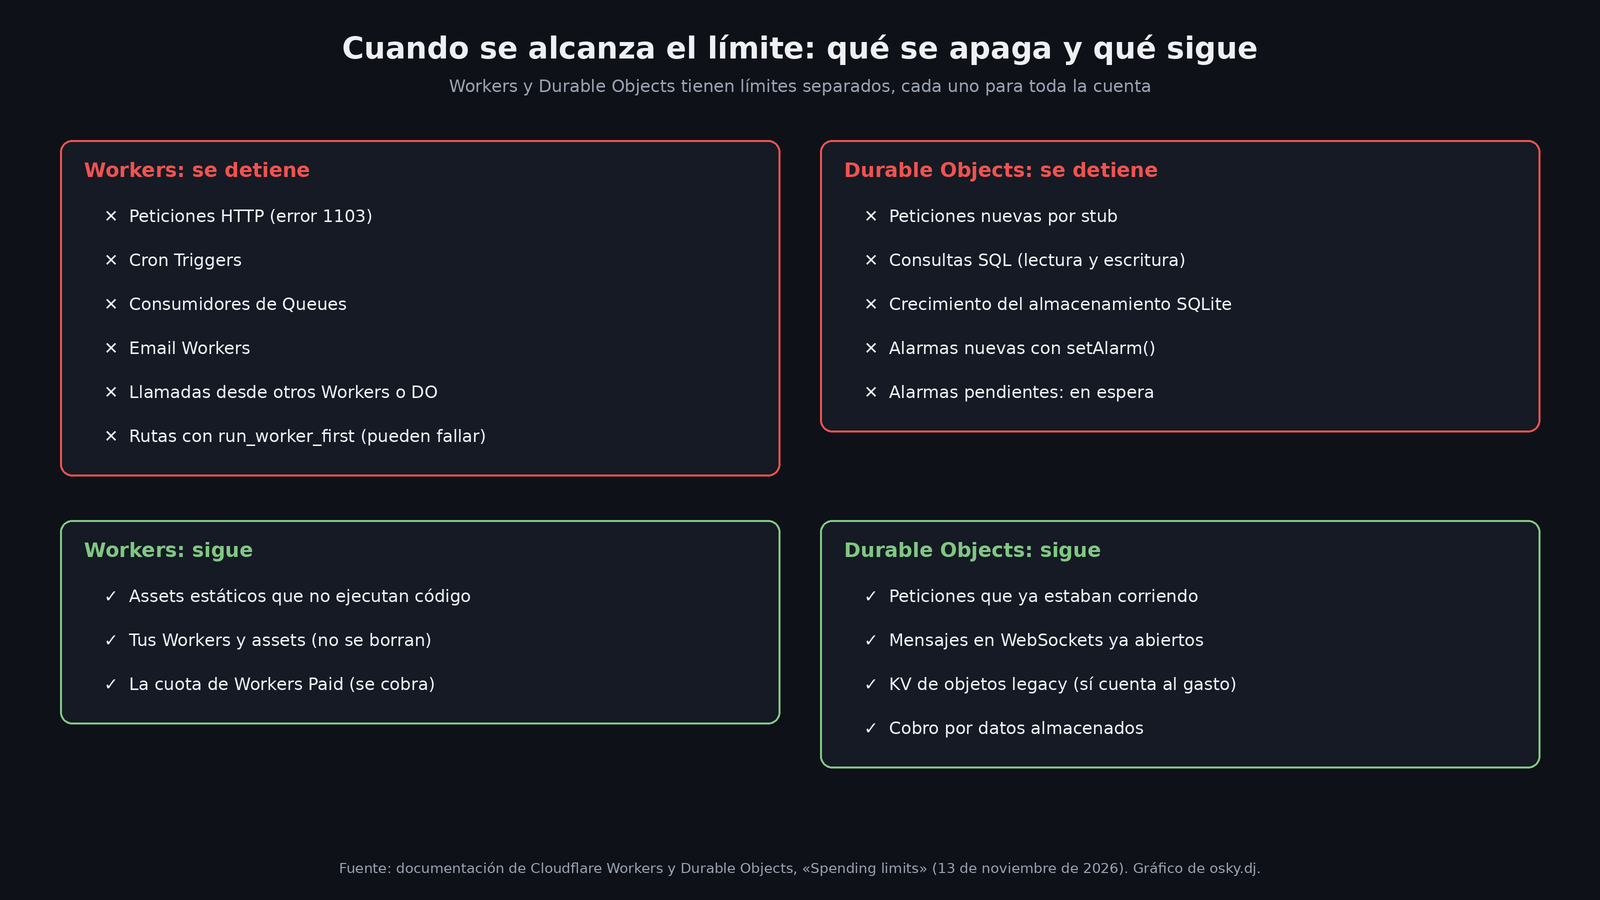
En Workers, una vez que el límite surte efecto se rechazan las invocaciones nuevas: peticiones HTTP (el visitante ve el error 1103), Cron Triggers, consumidores de Queues, Email Workers y llamadas desde otros Workers o Durable Objects. Las peticiones rechazadas no se cobran como invocaciones. Los assets estáticos que se sirven sin ejecutar tu Worker siguen disponibles, pero lo que necesite código (por ejemplo, rutas con run_worker_first) puede fallar. Nada se borra.
En Durable Objects se rechazan las peticiones nuevas por stub, las consultas SQL (lectura y escritura), el crecimiento del almacenamiento SQLite y las alarmas nuevas con setAlarm(). Las alarmas pendientes se quedan en espera hasta que termine el bloqueo, sujetas a un límite de siete días, y esas esperas no consumen sus reintentos normales. Lo que no se detiene: peticiones que ya estaban corriendo (siguen generando cargo por duración), mensajes en WebSockets ya abiertos, operaciones de objetos legacy con almacenamiento clave-valor (que sí cuentan para el gasto) y el cobro por datos almacenados.
Para reanudar hay tres caminos: subir el límite por encima de lo gastado, apagar el límite o borrarlo. Los cambios tardan unos minutos. Si no haces nada, el bloqueo expira solo al empezar el siguiente periodo de facturación, y el límite queda configurado para el nuevo ciclo.
La letra chiquita: no es una factura máxima
Cloudflare lo dice sin rodeos en su documentación: un límite de gasto no es un monto máximo exacto. El gasto se ve casi en tiempo real, con menos de 10 minutos de retraso, y entre medir y bloquear siempre hay un hueco. Los retrasos de medición, las operaciones en curso y hasta fallas en la aplicación del bloqueo pueden hacer que te pases. Además, que el dashboard diga «Limit reached» no confirma que el bloqueo ya se propagó en toda la red.
La razón está en cómo lo construyeron, y el anuncio lo explica con detalle:
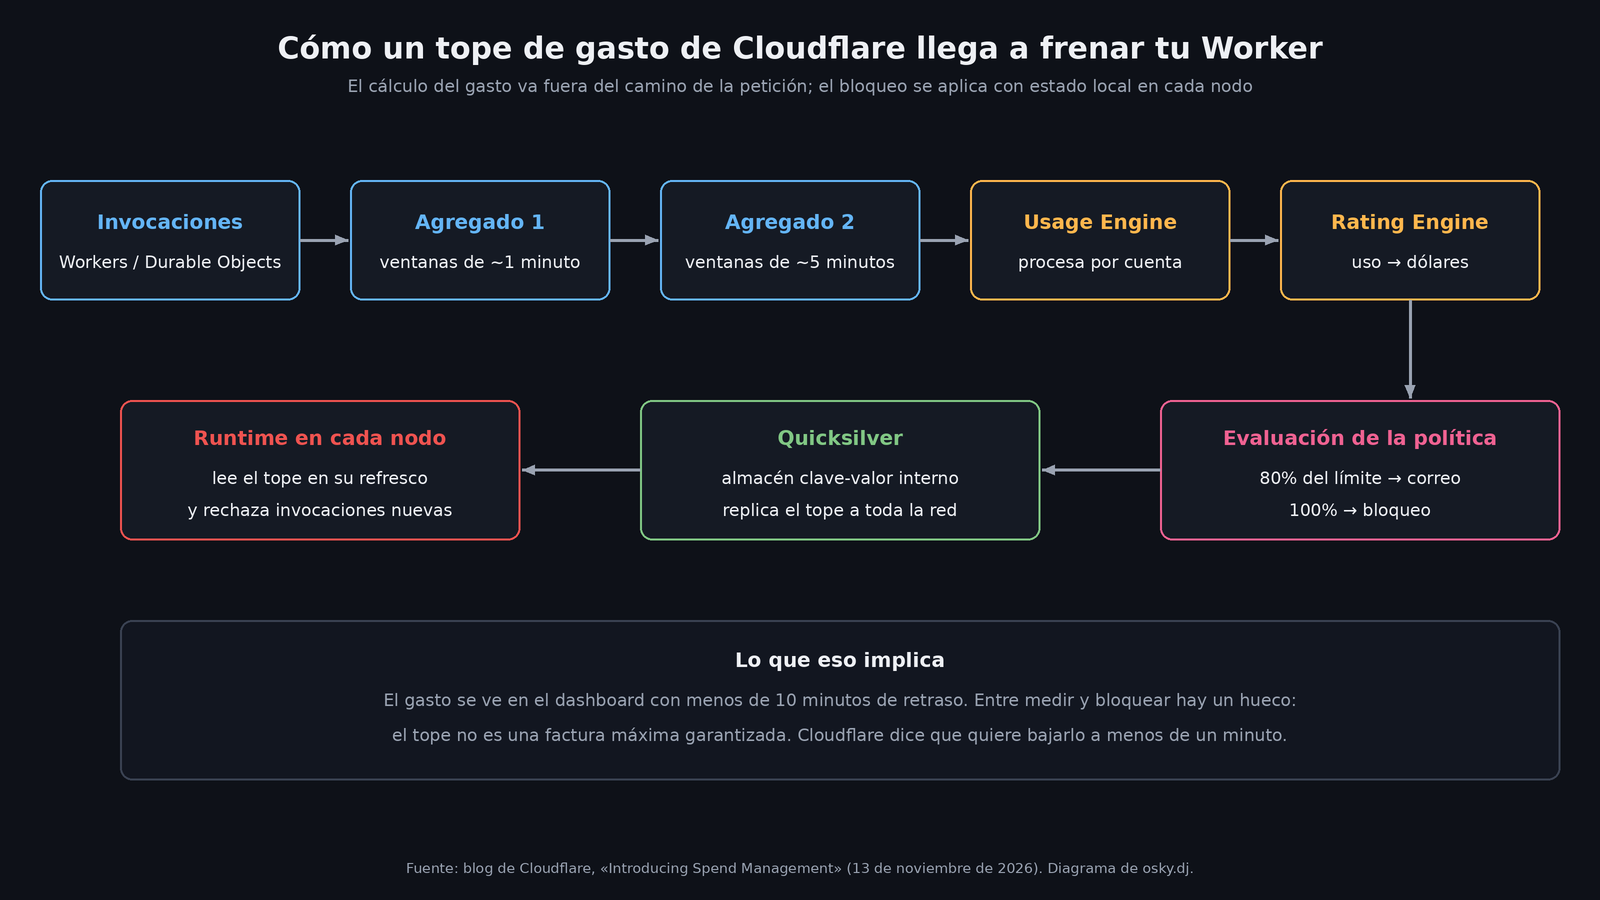
- Cada invocación genera mediciones (peticiones, CPU, duración, operaciones de almacenamiento) que se agregan cerca de la fuente en dos etapas: primero en ventanas de alrededor de un minuto y luego en ventanas de alrededor de cinco.
- Un Usage Engine convierte esas mediciones en registros de uso y procesa todo particionado por cuenta, con un registro de escritura anticipada (WAL) en disco para recuperarse si un procesador falla.
- El Rating Engine cruza uso, suscripción y precios para responder cuánto lleva gastado la cuenta. Si el uso llega antes que los datos de la suscripción, lo deja pendiente en vez de tratarlo como gratis.
- El bloqueo no se decide en el camino de la petición: la política se publica en Quicksilver, el almacén clave-valor interno de Cloudflare, y el runtime de cada nodo la toma en su refresco periódico. Así ninguna petición espera al motor de cobro, pero el freno llega con retraso.
Cloudflare dice que quiere bajar ese hueco entre medición y bloqueo a menos de un minuto.
Lo que viene
El anuncio adelanta tres frentes: más productos con límite, menos latencia y presupuestos por aplicación o por agente. Lo último es lo interesante: hoy el límite es por producto, pero Cloudflare plantea poder etiquetar las llamadas de un agente de IA y pausar solo esa tarea o esa aplicación, sin tumbar todo lo demás de la cuenta. Para lo que ya existe en IA, la empresa recomienda combinarlo con los límites de gasto de AI Gateway, que permiten presupuestos por usuario, modelo o proveedor (hasta 20 reglas por gateway) y responden con un 429 cuando se acaba el presupuesto.
Mi lectura
Es una buena noticia, y tardía. Cualquiera que haya visto una factura de nube dispararse por un bucle o por un bot que encontró tu endpoint sabe que un correo a las tres de la mañana no sirve de mucho. Pero el diseño actual tiene dos riesgos que conviene tener claros antes de prender el freno:
- Es un interruptor general, no por proyecto. La propia documentación lo advierte: un Worker de pruebas puede llegar al límite compartido y tumbar al Worker de producción de la misma cuenta. Si mezclas staging y producción en una sola cuenta, un límite agresivo puede convertir un problema de costo en una caída. Separar cuentas, o poner el límite con margen amplio, deja de ser opcional.
- Pausar también es una decisión de negocio. Para un sitio personal o un proyecto de fin de semana, que se apague es mejor que pagar. Para algo que factura, un 1103 a media campaña puede salir más caro que el exceso. En ese caso, la alerta al 80% (que no bloquea) quizá sea la herramienta correcta, y el límite duro un seguro más arriba.
Mi recomendación práctica: activa primero las alertas por correo, mira un par de ciclos cuánto gastas de verdad y después fija el límite duro con colchón. Y no olvides ponerle correo al límite, porque el dashboard no lo hace por ti.
Fuentes
- Cloudflare: «Introducing Spend Management: Spending limits and alerts for Cloudflare» (13 de noviembre de 2026)
- Documentación de Cloudflare: Spending limits and alerts
- Documentación de Cloudflare Workers: Spending limits
- Documentación de Cloudflare Durable Objects: Spending limits
- Documentación de Cloudflare: Budget alerts
- Documentación de Cloudflare AI Gateway: Spend limits