/es/articulos/openai-rehizo-su-servidor-de-git-porque-codex-lo-estaba
OpenAI rehízo su servidor de Git porque Codex lo estaba ahogando: así funciona Pando
OpenAI publicó el 2 de noviembre de 2026 cómo rehízo el servidor de Git de su monorepo: un backend nuevo llamado Pando, compatible con el protocolo y el cliente de Git, que hoy atiende todo el desarrollo de ese repositorio. La razón es Codex. Los agentes multiplicaron los branches, los pushes y los fetches hasta que el sistema anterior no aguantó: según OpenAI, hubo momentos en que su confiabilidad bajó de 90%. Con Pando, la latencia mediana de un push bajó casi 80% (casi 5 veces) y el servicio entrega cerca de un petabyte de datos de Git al día. Para quien opera repositorios grandes, CI o flotas de agentes que hacen git push sin parar, este es el primer reporte serio de cómo se rompe Git a escala de agentes y qué se tuvo que sacrificar para arreglarlo.
El problema: Codex multiplicó el tráfico
OpenAI dice que, con Codex, un solo ingeniero tiene varios cambios listos para CI al mismo tiempo, y cada push puede disparar varios trabajos que descargan el mismo commit. Más branches, más merges, más clones desde entornos de desarrollo, trabajos de investigación y CI. El efecto se acumula.
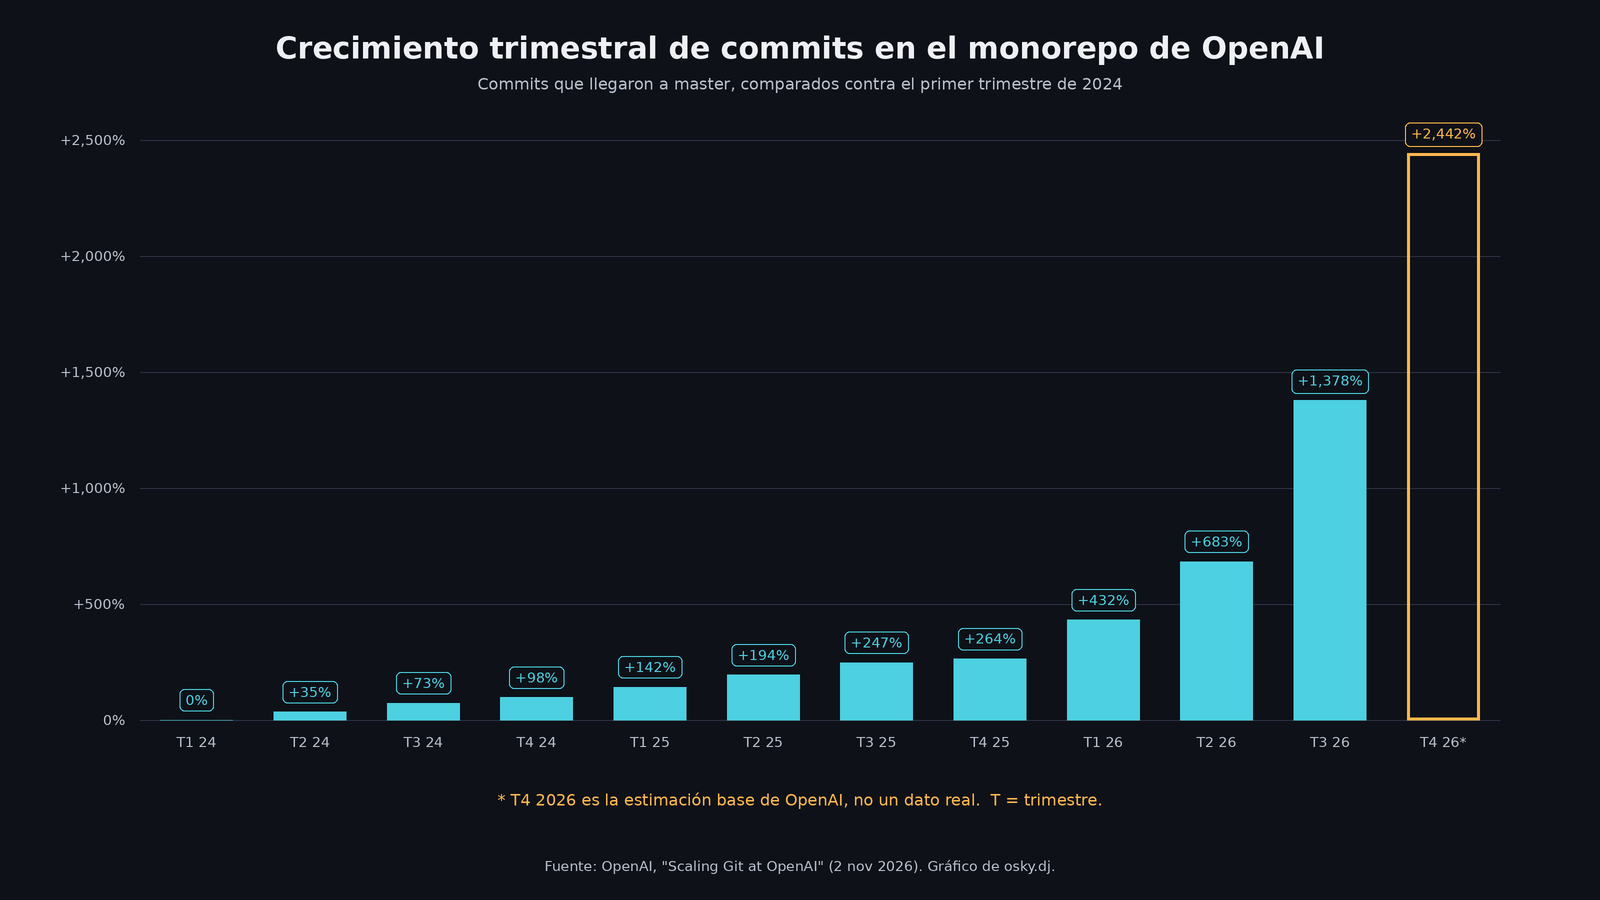
La gráfica que publicó lo deja claro. Los commits que llegan a master crecieron 264% entre el primer trimestre de 2024 y el último de 2025, y 1,378% para el tercer trimestre de 2026. Para el cuarto trimestre de 2026 OpenAI estima 2,442%, pero ojo: ese último número es una proyección suya, no un dato medido, aunque algunos titulares lo citen como si ya hubiera pasado.
Desde finales de 2025, según el texto, los pushes y fetches eran lentos y los merges fallaban. La pregunta que se hicieron fue si habían topado con un límite de Git o con un límite de cómo servían su monorepo. Su conclusión fue que podían conservar el flujo de Git de siempre y rehacer el backend.
Los dos caminos clásicos y por qué no alcanzaban
OpenAI modeló las dos formas comunes de escalar un servidor de Git:
| Enfoque | Cómo coordina | Dónde se atora |
|---|---|---|
| Three-phase commit (3PC) | Réplicas completas del repo; una mayoría debe aceptar cada actualización de ref | Cada push espera varias rondas entre réplicas y el disco de cada una; las escrituras se vuelven lentas bajo carga |
| Write-ahead log (WAL) en blob storage | Un manifiesto compartido que se actualiza con compare-and-swap | Hasta los pushes a branches que no tienen nada que ver compiten por el mismo manifiesto; las réplicas se atrasan en leer e indexar packs y las lecturas se vuelven lentas |
En los dos casos el cuello de botella es el mismo: el sistema ordena todas las escrituras del repositorio en una sola fila.
Las dos concesiones de Pando
Pando renuncia a dos cosas que casi todos los servidores de Git dan por hecho.
1. Consistencia de todo el repositorio en un mismo instante. Pando garantiza el orden de las actualizaciones de cada ref por separado, pero no una foto simultánea de todos los branches. OpenAI lo llama consistencia causal: dos clientes solo chocan si empujan al mismo ref al mismo tiempo. El costo es que un cliente que lee varios branches puede verlos en momentos distintos. Su argumento es que, en la práctica, ni personas ni agentes dependen del orden global, solo del orden de cada branch.
2. Un packfile hecho a la medida de cada cliente. Un servidor normal calcula qué objetos le faltan a quien hace fetch y arma un pack nuevo, lo cual cuesta CPU y disco y casi no se puede cachear. Pando guarda el packfile que llegó en cada push como un blob inmutable y lo reutiliza para servir a todos los que lo pidan después. A veces el cliente descarga objetos que ya tenía, pero el servidor casi no calcula nada.
Para que esos packs se puedan reutilizar, Pando no le muestra al cliente todos sus branches durante el push: por defecto solo anuncia un branch troncal. Así el pack depende solo de esa base y cualquiera que la tenga puede usarlo. OpenAI reconoce que, si alguien empuja muchas veces al mismo branch o apila branches, cada push reenvía todo lo que está fuera de la troncal. En su monorepo, la mediana de esos packs quedó debajo de 20 KiB y el percentil 99 debajo de 3 MiB.
Cómo funciona por dentro
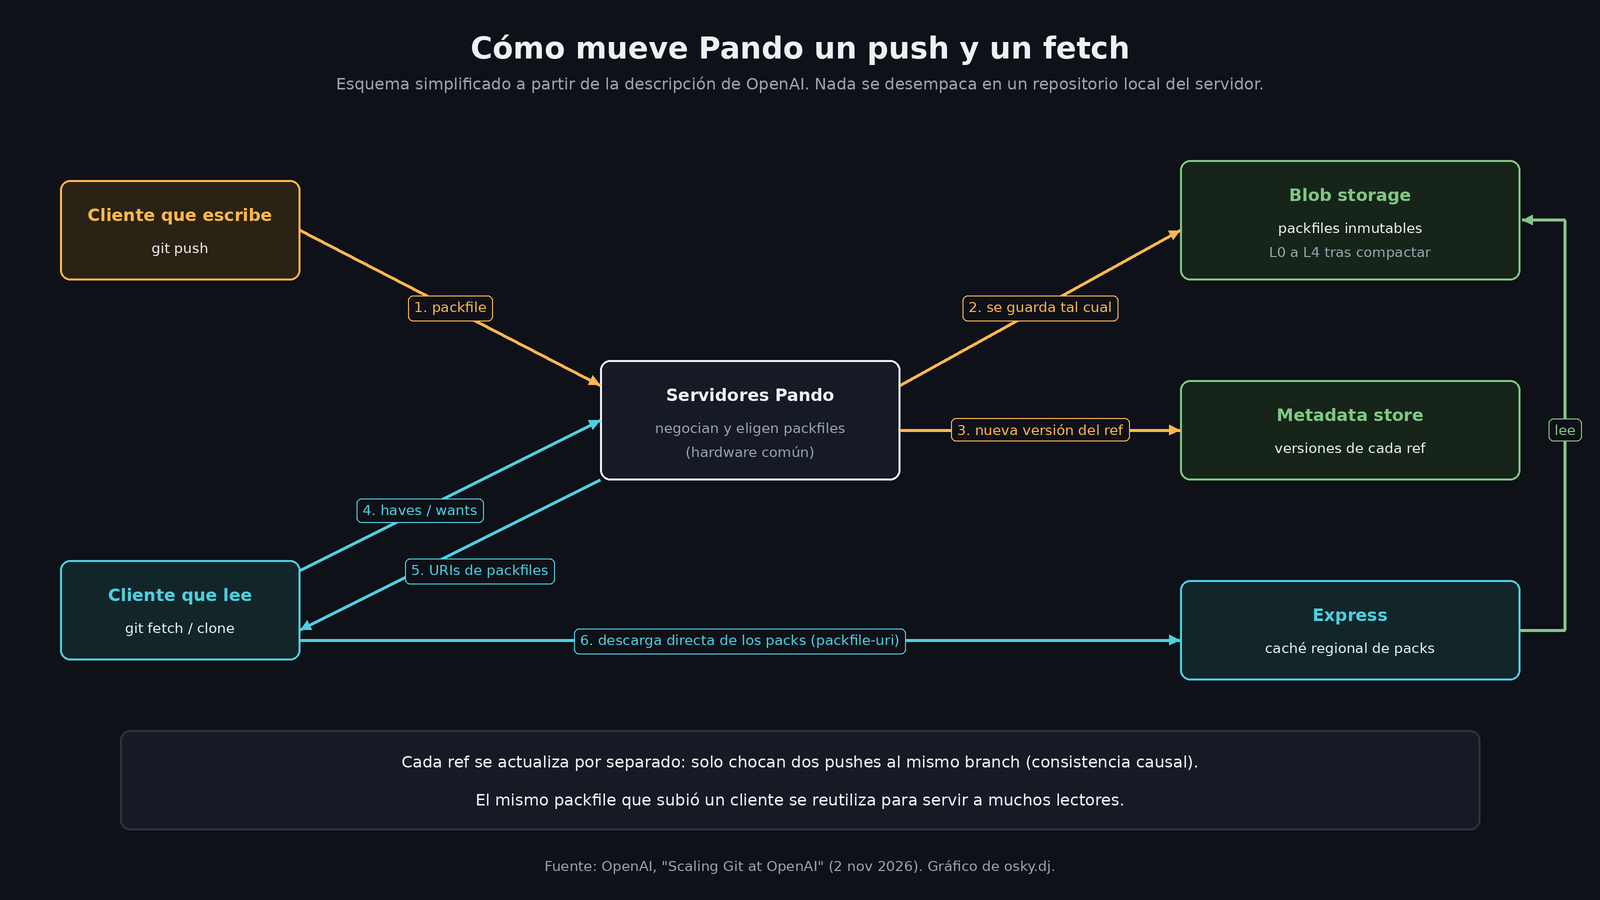
- Push. Pando valida el packfile mientras lo transmite a blob storage, sin desempacarlo en un repositorio local. Después, en una transacción, registra una versión del ref (la nueva punta, el pack que la trajo y sus dependencias) y mueve el puntero del branch con una operación atómica tipo compare-and-swap. OpenAI dice que esto cuesta un número constante de lecturas y escrituras de metadatos, sin importar el tamaño del push.
- Fetch. Con los
havesywantsdel cliente, Pando busca las versiones de ref que necesita y responde con ligas a packfiles ya guardados, usandopackfile-uri, una función poco conocida del protocolo de Git. El cliente los baja de Express, un caché regional; OpenAI reporta aciertos de caché arriba de 99%. - Compactación. Como bajar un pack por cada push sería impráctico (decenas de miles al día), unos workers agrupan los packs pequeños en niveles, al estilo de los árboles LSM. Hoy el monorepo usa hasta el nivel L4. Esos niveles también funcionan como índice para elegir los packs en tiempo logarítmico, y ningún nivel se borra.
Según OpenAI, con máquinas virtuales estándar de un proveedor de nube los clones y fetches llenan enlaces de 10 Gbps. Pando llegó a servir más de 57 TB de packs en una hora, más de 99% desde caché en disco local.
Hecho con Codex en 10 semanas
El dato que más va a circular: Pando pasó de arranque a producción en 10 semanas. OpenAI dice que el núcleo lo diseñó un solo ingeniero, lo implementaron equipos de agentes y lo desplegaron unos cuantos ingenieros. Está escrito en Rust, sin dependencias heredadas, con una batería de pruebas de conformidad contra el comportamiento estándar de Git y pruebas de simulación determinista. También dicen que usaron agentes para escribir especificaciones formales en Lean y TLA+ con las que encontraron y corrigieron errores. Atiende tráfico de producción desde abril de 2026.
La migración se hizo sin apagar nada: primero Pando funcionó como proxy de lectura y escritura frente al sistema anterior, y los clientes se movieron por fases con un wrapper interno del CLI de Git. OpenAI incluso reparte su propia compilación de Git en las máquinas de sus desarrolladores y dentro de la app de escritorio de ChatGPT.
Lo que sí te llega a ti
Pando no es un producto que puedas instalar. OpenAI solo dice que está explorando formas de compartir la tecnología con sus usuarios, sin fechas. Lo que sí es público:
- Su fork de Git en GitHub (
openai/git), con mejoras como descargar e indexar packs en paralelo y las explicit haves, que permiten usar--force-with-leasey construir el pack solo contra la troncal. - Parches a Git upstream: correcciones en descargas concurrentes, limpieza tras transferencias interrumpidas, reanudación de descargas y trazas para
packfile-uri. Su rastreador público de parches lista 50 para upstream; varios ya están en Git y otros siguen en revisión.
Mi lectura
Lo interesante no es que OpenAI tenga un monorepo enorme, sino cómo lo resolvió: se quedó con Git como interfaz y cambió las garantías del servidor. Es una apuesta a que el cliente de Git, que ya usan todos los humanos y todos los agentes, vale más que la consistencia global.
Para un equipo chico esto no cambia el lunes: un GitLab o un Gitea en un VPS aguanta de sobra. Pero la tendencia sí importa. Si pones agentes a abrir branches, correr CI y empujar cambios en paralelo, tu servidor de Git deja de ser infraestructura aburrida y se vuelve cuello de botella. Antes de comprar más disco, conviene medir cuántos fetches dispara cada push y cuántas veces CI clona lo mismo.
Un detalle de rigor: algunas coberturas dicen que la confiabilidad de los merges llegó a 99.99%. El texto de OpenAI no da esa cifra; solo dice que mejoró. Esta nota sale del artículo técnico de OpenAI y de sus repositorios públicos; no lo probé.