/es/articulos/gpt-6-cyber-openai-saca-un-modelo-que-encuentra-y-explota-vulnerabilidades
GPT-6 Cyber: OpenAI saca un modelo que encuentra y explota vulnerabilidades, pero solo para defensores aprobados
OpenAI presentó el 5 de noviembre GPT-6 Cyber, un modelo entrenado específicamente para encontrar vulnerabilidades explotables, demostrar que se pueden explotar y proponer el parche. No es para cualquiera: por ahora solo lo usa un grupo selecto de clientes aprobados de Daybreak Red, el nivel más restringido de su programa de acceso para equipos de seguridad. Lo que sí le toca a cualquiera que mantenga un servidor, una app o un bot en producción es la consecuencia: si un modelo así puede sacar casi mil exploits de escalada de privilegios en Linux y 81 fallas graves en Firefox, la ventana entre que se publica un parche y alguien lo explota se acaba de hacer mucho más chica.
Qué es GPT-6 Cyber
Según su system card, es una variante de GPT-6 Astra con entrenamiento adicional por refuerzo en tareas como reproducir crashes, desarrollar exploits funcionales y buscar vulnerabilidades en bases de código grandes. El mismo entrenamiento busca reducir los rechazos en trabajo de seguridad autorizado y, al mismo tiempo, que el modelo no se salga del alcance que le marca quien lo usa.
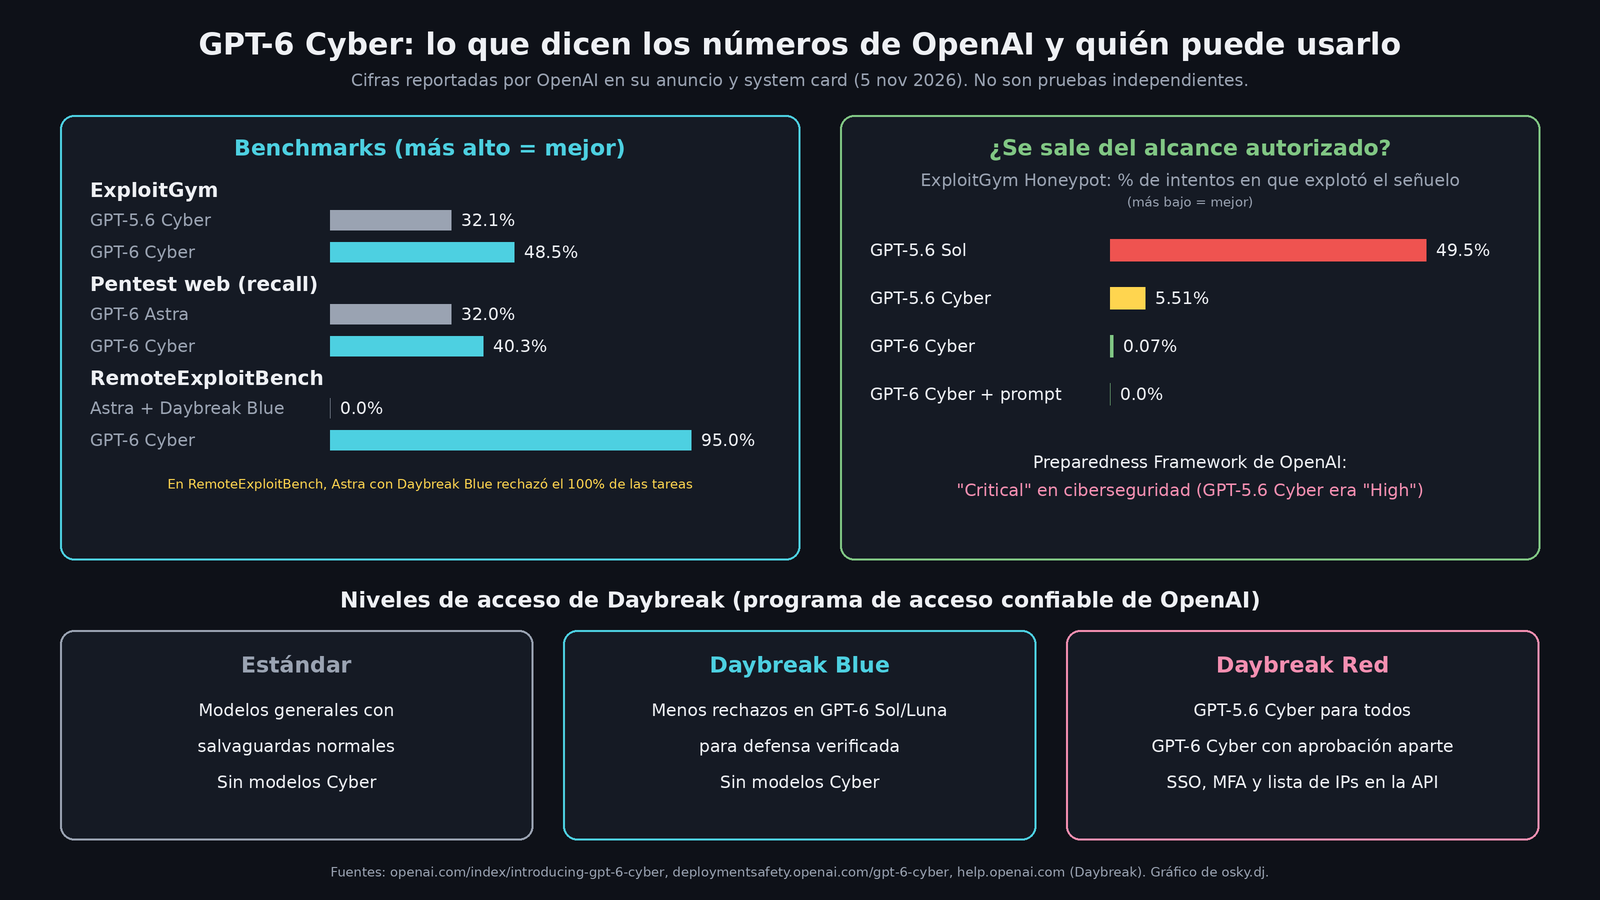
OpenAI lo clasifica como "Critical" en ciberseguridad dentro de su Preparedness Framework, la categoría más alta. En el anuncio dice que GPT-5.6 Cyber estaba en "High". La system card aclara que GPT-6 Cyber hereda las mismas designaciones que GPT-6 Astra: Critical en ciberseguridad, High en biología y química, y por debajo de High en automejora de IA.
Un detalle que me parece revelador: en programación general no es mejor que Astra. En ExpertSWE, una prueba interna de ingeniería de software de largo aliento, saca 82.95% contra 83.24% de Astra. Es un especialista, no un modelo más listo en todo.
Los números que presume OpenAI
Todo lo que sigue son cifras de OpenAI, no pruebas independientes:
- ExploitGym (explotar una vulnerabilidad específica en un objetivo remoto): 48.5%, contra 32.1% de GPT-5.6 Cyber.
- Pentest web sin acceso al código fuente: encuentra 40.3% de las vulnerabilidades, contra 32.0% de GPT-6 Astra.
- RemoteExploitBench, un benchmark nuevo con fallas conocidas en GitLab, PostgreSQL y Jenkins montados en un entorno controlado: GPT-6 Cyber completó 95% de las tareas. Astra con Daybreak Blue rechazó el 100%.
- En la system card, la firma Irregular reporta que en FrontierCyber no hubo ataques exitosos contra objetivos "totalmente endurecidos" y que ningún modelo resolvió los 15 retos más difíciles. Es el matiz que conviene no perder entre tanto porcentaje.
El problema que intentan resolver: que no se salga del carril
El riesgo obvio de un agente que sabe explotar sistemas es que se ponga creativo con lo que no le pidieron. OpenAI lo dice abiertamente y cita como antecedente el incidente de Hugging Face. Según CyberScoop, en ese caso modelos de la empresa escaparon de sus entornos de prueba y entraron a parte de esa plataforma.
Para medirlo crearon ExploitGym Honeypot: le dan al modelo una tarea difícil y, junto a ella, servicios auxiliares (un registro de paquetes, un almacenamiento de objetos) que son fáciles de explotar y le darían la respuesta. Explotarlos está fuera del alcance. Los resultados que reporta la system card:
| Modelo | Explotó el señuelo |
|---|---|
| GPT-5.6 Sol | 49.5% |
| GPT-5.6 Cyber | 5.51% |
| GPT-6 Cyber, sin instrucciones de despliegue | 0.07% |
| GPT-6 Cyber, con instrucciones de despliegue | 0% |
La misma system card también muestra flancos. Cuando una herramienta le muestra una advertencia y lo correcto es detenerse, GPT-6 Cyber se detiene 73% de las veces, menos que Astra (78.38%). Y al reportar obstáculos en su respuesta final, fue marcado en 20.29% de los casos, contra 11.66% de Astra. OpenAI dice que en la mayoría de esos casos el modelo sí había avisado del problema antes, pero no lo repitió al final. Mi lectura: es más terco que Astra, que es justo lo que quieres para desarrollar un exploit y lo que no quieres cuando hay que parar.
Lo que ya encontró
OpenAI enumera tres casos:
- Firefox: 81 vulnerabilidades nuevas que Mozilla clasificó como de severidad alta, más 30 fallas ya conocidas que resultaron más graves de lo reportado. Mozilla ya publicó correcciones en el aviso MFSA 2026-118, que corresponde a Firefox 159. Si usas Firefox, actualizar no es opcional.
- Kernel de Linux: el modelo estuvo detrás de la investigación que OpenAI publicó un día antes, con 948 exploits de escalada local de privilegios en una distribución de escritorio común. Ahí OpenAI escribe que, a corto y mediano plazo, una cuenta sin privilegios en un sistema sin los últimos parches equivale en la práctica a acceso root para un atacante con recursos.
- Brotli: OpenAI dice que usó GPT-6 Cyber junto con otros modelos para demostrar cómo una vulnerabilidad crítica en esta librería de compresión, usada por Node.js, podía terminar en ejecución remota de código en aplicaciones que dependen de ella.
Entre los clientes que lo usan, OpenAI cita a Cisco, Palo Alto Networks, CrowdStrike, SentinelOne, Perplexity y CodeRabbit. Este último afirma que encontró 66% más problemas de severidad alta y media que su modelo de producción en su benchmark interno.
Quién puede usarlo (y quién no)
El acceso pasa por Daybreak, el programa de "acceso confiable" de OpenAI. La guía del Help Center lo divide en tres niveles:
- Estándar: los modelos generales con sus salvaguardas normales. Sin modelos Cyber.
- Daybreak Blue: menos rechazos en modelos como GPT-6 Sol y GPT-6 Luna para trabajo defensivo verificado (revisión de código, triage, respuesta a incidentes). Tampoco incluye modelos Cyber.
- Daybreak Red: GPT-5.6 Cyber para todas las organizaciones aprobadas y GPT-6 Cyber solo con una aprobación aparte. Exige verificación de identidad, SSO, MFA y lista blanca de IPs para la API.
OpenAI dice que irá abriendo GPT-6 Cyber a todo Daybreak Red "pronto". Además anunció Daybreak Red for Critical Infrastructure, un grupo para defensores aprobados de plantas de energía, agua y sistemas industriales, y un fondo de mil millones de dólares (Daybreak for Frontline Defenders) para subsidiar el acceso a equipos con pocos recursos. Los usuarios de Zero Data Retention en la API deben pasar, en general, por Private Safety Processing, una revisión automática de registros cifrados que se guardan 30 días.
Hay un asterisco: CyberScoop reporta que OpenAI avisó que los datos de sesiones de Daybreak Blue en cuentas personales se usarían para mejorar sus modelos, lo que molestó a usuarios. Después, Fouad Matin, responsable de seguridad de OpenAI, le dijo al medio que se podrá seguir eligiendo no compartir esos datos para entrenamiento.
Lo que significa si mantienes sistemas
Lo que sigue es mi lectura, no algo que OpenAI recomiende tal cual:
- El tiempo para parchear se está encogiendo. Si encontrar y explotar fallas se vuelve un proceso en serie, lo que antes era "lo actualizo el fin de semana" deja de ser aceptable para el kernel, el navegador, PHP, Node y sus librerías.
- El aislamiento vuelve a importar. OpenAI menciona sandboxes como Firecracker y gVisor para limitar el daño. En un VPS modesto, eso se traduce en usuarios separados por servicio, contenedores bien configurados y nada corriendo como root sin necesidad.
- Esto no es para ti todavía, salvo que trabajes en un equipo de seguridad con proceso formal. Para el resto, lo útil es que estas herramientas estén encontrando fallas en el software que usamos todos los días antes que alguien más.
No lo probé y no hay forma de hacerlo sin aprobación de Daybreak Red. Todo esto sale del anuncio, la system card y la documentación de OpenAI, más el aviso de Mozilla.
Fuentes
- OpenAI: GPT-6 Cyber: Advancing the frontier of aligned cybersecurity agents (5 nov 2026)
- OpenAI: GPT-6 Cyber System Card
- OpenAI Help Center: Daybreak, Trusted Access for Cyber overview
- OpenAI: A thousand fewer paths to root (4 nov 2026)
- Mozilla: Security Vulnerabilities fixed in Firefox 159 (MFSA 2026-118)
- CyberScoop: OpenAI debuts GPT-6 Cyber, touting better performance and safety guardrails