/es/articulos/cloudflare-deja-de-reconstruir-zonas-dns-enteras-por-un-ajuste
Cloudflare deja de reconstruir zonas DNS enteras por un ajuste: 85% menos memoria y la mitad de retraso
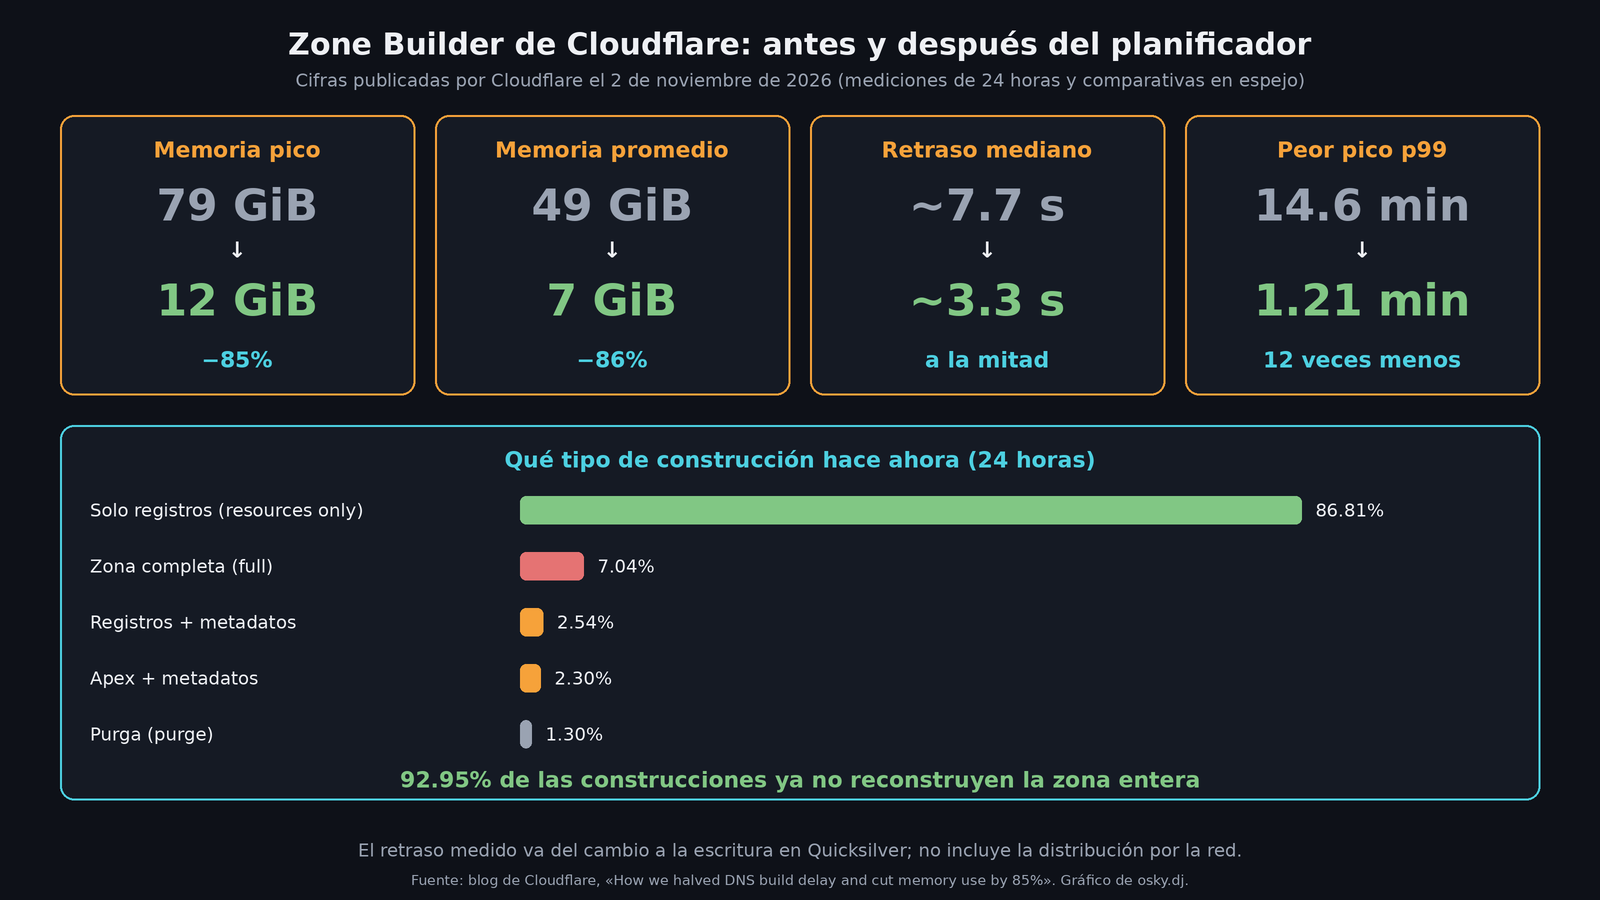
Cloudflare publicó el 2 de noviembre de 2026 un análisis técnico sobre cómo rediseñó el sistema que convierte cada cambio de DNS en datos que sus servidores autoritativos pueden servir. El resultado, según sus propias mediciones: la memoria pico de ese sistema bajó 85% (de 79 a 12 GiB), las construcciones completas de zona cayeron cerca de 40% y el retraso mediano entre que cambias un registro o un ajuste de zona y que ese cambio queda escrito en su almacén interno se redujo a menos de la mitad, de unos 7.7 a unos 3.3 segundos. No es un producto nuevo ni hay nada que configurar: es un cambio de ingeniería del lado de Cloudflare. Pero si tus dominios viven ahí, es tu DNS el que se mueve por esa tubería, y el texto deja varias lecciones útiles para quien diseña cualquier sistema que tiene que reconstruir estado a partir de eventos.
El problema: reconstruir todo por un ajuste
Cloudflare explica que su Zone Builder recibe hoy unos 700 cambios de registros DNS por segundo, casi el triple que en 2022, más unos 100 eventos de otro tipo, como cambios de ajustes de zona. Algunas zonas ya tienen más de 20 millones de registros y la empresa espera que crezcan hacia cientos de millones.
La tubería, en versión simplificada, va así: el cambio se guarda en una base de datos, genera un evento en Kafka, un agregador junta eventos de varios tópicos y se los pasa al Zone Builder, que lee los datos de la zona, los convierte en llaves que entienden los servidores autoritativos y escribe solo lo que cambió en Quicksilver, el almacén clave-valor distribuido que reparte la configuración por toda la red.
En 2022, Cloudflare ya había resuelto la parte fácil: las construcciones por registro, que en promedio eran 150 veces más rápidas que reconstruir toda la zona. Lo que quedó pendiente fueron los ajustes de zona. Un ajuste como Universal SSL puede cambiar los registros CAA del apex (el dominio pelón, tipo example.com) y los metadatos de la zona. Como un evento de zona puede venir de muchos productos y no siempre dice qué cambió, el sistema hacía lo seguro: leer, codificar y comparar todos los registros de la zona, con la zona completa en memoria. Para zonas chicas, barato. Para las de decenas de millones de registros, según el propio Cloudflare, la zona ni siquiera cabe en memoria.
La solución: un planificador que elige la construcción más chica que es segura
La pieza central es un planificador de construcciones dirigidas. Primero cambiaron el productor de eventos para que incluya qué campos y ajustes cambiaron, con su valor anterior y nuevo cuando existe. Después rastrearon cada ajuste por el código que genera la salida DNS para clasificar qué puede afectar.
Con eso, el planificador elige entre cinco tipos de construcción:
- Solo registros: reconstruye los nombres DNS afectados sin tocar metadatos. Es el camino normal de cambios A, AAAA, TXT y CNAME.
- Registros y metadatos: para cambios de nameservers y comodines.
- Apex y metadatos: para ajustes como Universal SSL.
- Purga: retira una zona que ya no debe publicarse.
- Zona completa: cuando no se puede demostrar que algo más chico es seguro.
La regla que pone Cloudflare es estricta: cada llave que escribe una construcción dirigida tiene que ser idéntica, byte por byte, a la que escribiría una construcción completa. Si no lo pueden demostrar, se hace la completa. En sus palabras, el planificador "nunca convierte la incertidumbre en menos trabajo".
Hay una excepción deliberada: arriba de cierto número de registros, el sistema ya nunca escala a construcción completa, porque esas zonas no caben en memoria, la construcción no termina y, mientras reintenta, frena todos los demás cambios de su partición de Kafka. En esos casos reconstruye el apex, los metadatos y los nombres que señalan los eventos. Cloudflare reconoce que es un compromiso y que para los casos raros que quedan puede reconstruir nombres a mano.
Los detalles que lo hacen confiable
Lo interesante del texto no es el "lo hicimos más rápido", sino cómo evitaron dejar datos DNS viejos o incorrectos en el borde:
- Una misma zona, varios dueños internos. Durante altas, bajas y otros cambios de ciclo de vida pueden existir brevemente varias zonas internas con el mismo nombre de dominio. Hay una llave de metadatos compartida que dice cuáles se publican. Cuando una construcción la toca, la reconstruye completa desde una lectura fresca, en lugar de parchar una copia vieja, y escribe los registros antes que los metadatos que apuntan a ellos.
- Planear dos veces. El evento genera un plan conservador, pero justo antes de ejecutar, el Zone Builder vuelve a leer el estado: una construcción dirigida puede volverse completa, una puede convertirse en purga o puede saltarse. Esa lectura sale de réplicas de solo lectura, y como Kafka y la replicación van a velocidades distintas, el agregador retrasa los eventos lo suficiente y la base rechaza la lectura si la réplica va atrasada.
- Un solo planificador de horarios. Antes había dos (uno para registros y otro para zonas completas) que no podían combinar trabajo entre sí. El nuevo programador unificado junta los eventos de una misma zona que llegan antes de que arranque la construcción. Juntar solo puede sumar trabajo: si un evento pide zona completa, todo se vuelve zona completa.
- No perder mensajes. Usan soft committing, que ya habían descrito: una construcción puede terminar fuera de orden, pero el offset de Kafka solo avanza cuando todo lo anterior ya terminó. Si el proceso se reinicia, se repite trabajo en lugar de perder un cambio.
Para liberarlo hicieron pruebas de equivalencia (construcción completa contra dirigida, comparando byte por byte), corrieron durante el despliegue una construcción completa junto a cada dirigida y montaron un Zone Builder espejo que consume el Kafka de producción y escribe en un Quicksilver aparte que no sirve tráfico. Un comparador revisa una muestra de 20% de las zonas; en la captura que publican, la tasa de diferencias era de 0.31% sobre 234,313 zonas, que Cloudflare atribuye en su mayoría a desfases de tiempo entre los dos sistemas. El despliegue fue por hash del nombre de la zona, primero en zonas gratuitas y luego en las de pago.
Los números
En una medición de 24 horas, según Cloudflare:
| Tipo de construcción | Porcentaje |
|---|---|
| Solo registros | 86.81% |
| Zona completa | 7.04% |
| Registros y metadatos | 2.54% |
| Apex y metadatos | 2.30% |
| Purga | 1.30% |
Los dos tipos con metadatos antes eran construcciones completas; de ahí sale la caída de cerca de 40% en completas. Las que quedan duran en promedio 0.35 segundos porque, según el texto, las disparan sobre todo zonas nuevas y chicas.
Otros resultados reportados:
- Memoria: el promedio bajó de 49 a 7 GiB (86%) y el pico, de 79 a 12 GiB (85%).
- Peor cola: comparando producción con el espejo durante las mismas 24 horas, el pico más alto del p99 bajó de 14.6 a 1.21 minutos.
- Retraso mediano: con la memoria liberada se animaron a acortar el intervalo entre reconstrucciones de una misma zona en la mayoría de los planes y el tiempo que el agregador retiene eventos. La mediana pasó de unos 7.7 a unos 3.3 segundos. Con un histograma nativo de Prometheus, hoy reportan un p90 de unos 5.5 segundos y un p99 de unos 12.
- Kafka: ahora consumen al ritmo al que llegan los eventos, en lugar de atrasarse y ponerse al día en ráfagas de hasta 1,550 mensajes por segundo.
Lo que no dice
Hay que leer bien qué se midió. El retraso va desde el cambio hasta que el Zone Builder termina de escribir en Quicksilver. Cloudflare aclara que no incluye la distribución de Quicksilver por su red, que varía por ubicación y que este trabajo no tocó. También advierte que las cifras combinan todos los tipos de construcción y planes, así que "no son una garantía de latencia" para una zona en particular. Tampoco hay cifras por plan: el texto solo dice que el intervalo entre reconstrucciones depende del plan y que se acortó "en la mayoría".
Y algo que corrigen de sí mismos: en 2022 dijeron que planeaban eliminar las construcciones completas. Ahora dicen que no es realista ni útil, porque una zona que se publica por primera vez necesita escribir todo.
Mi lectura
Para quien tiene sus dominios en Cloudflare, el efecto práctico debería ser sutil: cambios de DNS y de ajustes de zona que llegan al borde un poco antes y menos picos raros de minutos. No hay nada que hacer de tu lado.
Lo valioso está en el método, y aplica a cualquier sistema que reconstruye estado desde eventos: un bot que recalcula catálogos, un CMS que regenera cachés, un pipeline de facturación. Mi lectura es que hay tres ideas que se pueden llevar a casa. Primero, que los eventos digan qué cambió; sin eso, el único camino seguro es reconstruir todo. Segundo, ante la duda, más trabajo y nunca menos. Y tercero, la prueba de fuego no fue un benchmark, sino un sistema espejo con tráfico real comparando la salida contra producción antes de soltarlo. Esa disciplina es la que separa una optimización de un incidente.
Fuentes
- How we halved DNS build delay and cut memory use by 85% (blog de Cloudflare, 2 de noviembre de 2026)
- How we improved DNS record build speed by more than 4,000x (blog de Cloudflare, 2022)
- Introducing Quicksilver: configuration distribution at internet scale (blog de Cloudflare)
- Secondary DNS deep dive (blog de Cloudflare)